
Browser Use + Jev:网页 Agent 为什么能在 7 秒内完成一次航班搜索
浏览器 Agent 长期有两个很现实的问题:慢,以及贵。
它们通常要反复读取页面、构造动作、调用模型、等待结果,再把新的页面状态交回模型。只要任务包含多个点击、筛选、输入和跳转,几十秒甚至几分钟很常见;如果每一步都使用通用大模型输出自然语言,成本也会随着动作数快速上涨。
2026 年 9 月,Browser Use 创始人 Gregor Zunic 发布了一段 Browser Use + Jev 的实测视频:在真实网页中搜索一段航班,演示画面标注为原速,流程用时约 7 秒,帖子披露的单次成本为 0.0039 美元。中文帖作者 AYi_AInotes 随后对这段演示进行了详细解读,并把它视为网页智能体从“每一步都让大模型慢慢思考”转向“让专用策略快速执行”的一个案例。
本文把两条 X 帖子放在一起整理,重点不是复述“快到不可思议”的宣传语,而是分析这次演示背后的工程结构:动作空间如何被缩小、DOM 状态如何取代整张截图、Jev 如何负责决策、小模型如何只在需要输入文字时接管,以及这些数字应该怎样验证。
原始视频与配图
原帖视频已经保存在本文资源目录中,下面的图片是 X 帖子提供的原始视频缩略图。
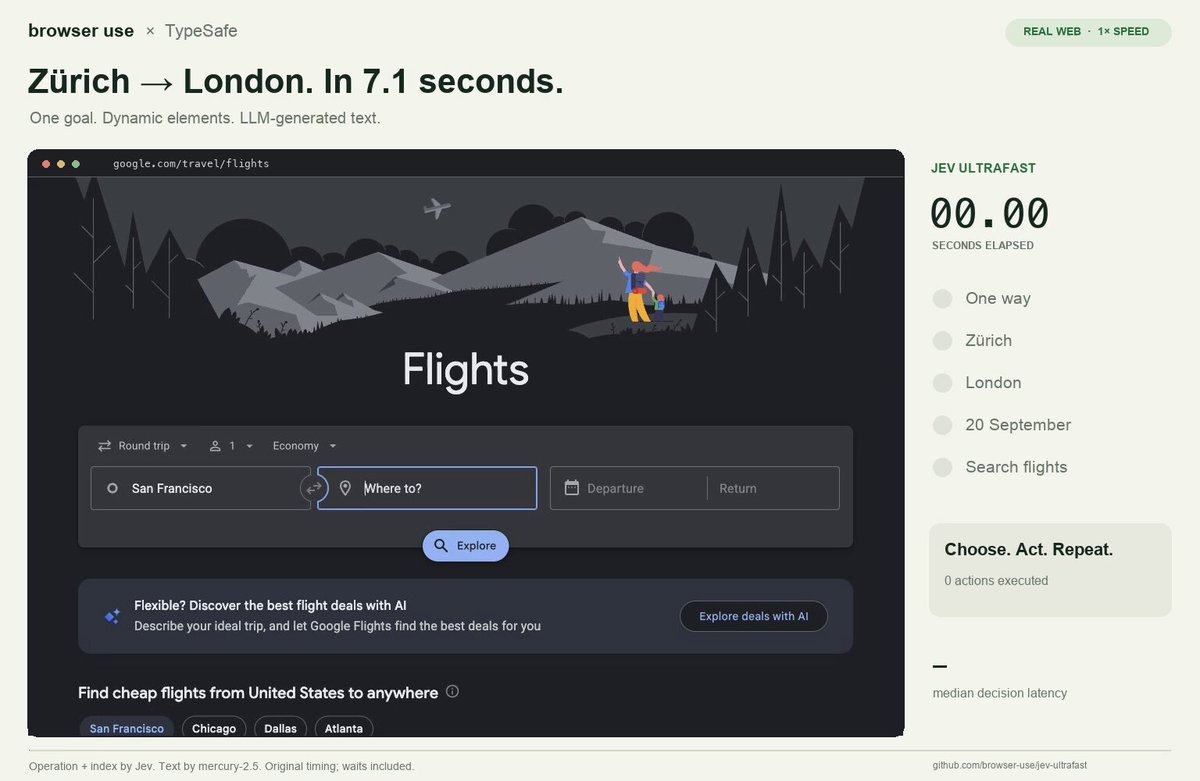
视频资源信息:H.264、1104×720、约 7.57 秒。视频中展示的是从打开航班页面、填写查询条件到得到结果的连续过程;原帖强调视频以 1 倍速播放。
一、两条来源分别说了什么
Gregor Zunic 的原始帖子
Gregor Zunic 的英文原帖给出了最小但最关键的实验描述:
- Browser Use 与 Jev 组合运行;
- 一次航班搜索约 7 秒完成;
- 公开披露的成本为 0.0039 美元;
- 每一步使用新的动作空间;
- Agent 直接面对 DOM 状态空间;
- 需要输入文字时,使用小型语言模型作为回退;
- 演示视频没有加速,按 1 倍速播放;
- 项目以开源 Browser Agent 的形式发布。
原帖没有给出完整的实验脚本、网络环境、网页稳定性、失败率、重复次数、模型版本与成本核算公式。因此,7 秒和 0.0039 美元应被视为这次演示的公开案例数据,不能直接当作所有网页、所有账号和所有任务的性能承诺。
AYi_AInotes 的中文解读
AYi 的中文帖把这次演示放进更大的行业叙事中:传统浏览器 Agent 往往依赖截图、完整 DOM 或通用模型的自然语言推理,而 Jev 这种不以自然语言输出为主的模型,更适合直接产生结构化动作决策。
中文帖重点强调了三个变化:
- 动作空间按当前页面动态生成,而不是每一步都暴露一整套固定动作。
- 大量页面跳转和点击交给高速策略模型,文字输入才交给小模型。
- 通过专用模型与小模型回退的组合,减少自然语言输出带来的 Token 和延迟开销。
其中“成本砍掉 450 倍”“毫秒级点击”等表述属于中文转述中的强调,不是 Gregor 原帖提供的完整对照实验。工程判断应优先使用原始视频、原始帖子和可重复脚本,而不是直接沿用二次解读中的夸张数字。
二、关键结构:不是让一个模型包办所有动作
传统浏览器 Agent 常被设计成一个大循环:
读取页面截图或大段 DOM
  → 通用大模型理解页面
  → 生成自然语言或工具调用
  → 浏览器执行
  → 重新读取页面
  → 再次请求模型
这个结构的优点是通用,缺点也很明显:
- 每一步输入可能很大;
- 页面无关区域会占用上下文;
- 模型输出中包含大量解释性文本;
- 点击、选择和跳转都要经过同一种昂贵推理路径;
- 任何一个页面状态变化都可能触发完整重算。
Browser Use + Jev 的演示更像一种分层执行器:
当前网页状态
  → 生成本步可用动作空间
  → Jev 选择点击 / 选择 / 导航动作
  → 浏览器执行
  → 只在需要文本时调用小模型
  → 进入下一步
重点不是把一个“大模型”换成另一个“更快的模型”,而是重新划分任务边界:视觉理解、页面状态表示、动作选择、文字生成和浏览器执行不必全部由同一个模型承担。
三、第一层优化:动态动作空间
固定动作空间的问题
如果每一步都把所有可能的浏览器操作暴露给模型,动作空间可能包含:
- 点击任意可交互元素;
- 输入任意文本;
- 选择下拉项;
- 滚动、返回、刷新和打开新标签页;
- 读取页面、等待、截图和执行脚本;
- 处理弹窗、日期选择器和分页控件。
动作越多,模型越难判断当前真正可行的选项,也越容易出现无效调用和重复尝试。
动态动作空间的思路
动态动作空间只把当前状态下真正可用、与任务相关的动作交给策略模型:
页面状态 S_t
  → 识别当前可操作元素
  → 根据任务过滤动作
  → 生成 A_t = {a1, a2, ..., an}
  → 选择下一动作 a_t
在航班搜索场景中,输入起点、输入终点、选择日期和点击搜索,不需要和页面上所有导航链接、广告入口、帮助按钮一起竞争。动作数量减少后,模型决策不只更快,也更容易校验。
动作空间必须包含语义和约束
动作空间不能只是元素编号,还需要带上足够的结构化信息:
| 字段 | 用途 |
|---|---|
action_id | 稳定标识当前动作 |
role | button、textbox、combobox 等元素角色 |
name | 可读的可访问名称或页面标签 |
target | 元素定位信息或浏览器内部引用 |
allowed_args | 该动作接受的参数 |
risk | 是否会提交、购买、发送或产生外部副作用 |
state_version | 防止用旧页面状态操作新页面 |
这样,策略模型输出的不是任意文本,而是可以被运行时验证的动作对象。
四、第二层优化:从截图优先转向 DOM 状态优先
截图对视觉任务很有价值,但对于大量标准网页操作来说,截图并不是最紧凑的状态表示。一个网页截图需要模型重新识别文字、按钮、输入框和当前焦点;而 DOM、可访问性树和浏览器事件状态可以直接表达很多确定信息。
DOM 状态能提供什么
对于标准表单,DOM 或可访问性树通常能告诉 Agent:
- 当前有哪些输入框;
- 输入框的标签、占位符和当前值;
- 哪些按钮处于可用状态;
- 下拉框有哪些选项;
- 某个元素是否隐藏、禁用或被遮挡;
- 页面是否已经进入加载、完成或错误状态。
这类信息适合直接服务于动作生成和校验。
DOM 优先不等于完全不要视觉
真实网页仍然存在这些情况:
- 关键内容绘制在 Canvas 中;
- 页面依赖复杂 CSS 或虚拟列表;
- DOM 文本与视觉位置不一致;
- 弹窗、遮罩和焦点状态只能通过画面确认;
- 图表、地图和图片内容需要视觉理解。
更可靠的方案是按任务选择状态表示:
标准表单 / 链接 / 按钮 → DOM / Accessibility Tree
视觉布局 / Canvas / 图表 → 截图或视觉模型
两者冲突 → 暂停并做状态复核
如果只相信 DOM,可能漏掉遮罩和视觉层状态;如果每一步都只看截图,又会牺牲速度和成本。正确目标是让视觉成为按需能力,而不是唯一入口。
五、第三层优化:Jev 负责动作,语言模型负责文字
Gregor 原帖明确写到,系统使用“小型语言模型回退来输入文字”。这意味着浏览器 Agent 的能力被拆成至少两条路径:
动作决策路径:Jev → 点击、选择、跳转、状态推进
文字输入路径:小模型 → 生成或修正要输入的文本
这是一种很实用的模型路由方式。
为什么文字输入值得单独处理
点击搜索按钮是有限动作;但在输入框中填入机场、人名、商品名或地址,往往需要:
- 生成目标文本;
- 处理用户原始意图;
- 做拼写和格式转换;
- 解决页面自动补全;
- 判断是否需要清空旧值;
- 处理多语言和特殊字符。
这类任务仍然需要语言理解,不适合强行压缩成纯动作分类。
Fallback 不是失败,而是能力边界
好的回退机制不是“主模型失败后随便找一个模型”,而是事先定义哪些动作由谁负责:
| 动作 | 默认执行者 | 回退条件 |
|---|---|---|
| 点击按钮 | Jev / 专用策略模型 | 目标元素不存在、状态版本过期 |
| 选择日期 | Jev / 结构化动作模型 | 日历是 Canvas 或状态无法确认 |
| 输入城市 | 小型语言模型 + 浏览器输入 | 文本需要生成、改写或纠错 |
| 读取航班结果 | DOM 解析器 | 页面结构异常时转截图/视觉解析 |
| 提交订单 | 人工确认或高风险策略 | 任何付款、发送或不可逆操作 |
这能把模型能力与风险边界同时写进系统,而不是依赖模型临场判断。
六、7 秒和 0.0039 美元应该怎样理解
这两个数字很吸引人,但发布到工程文档时必须把它们放回实验上下文。
时间不是单纯的模型延迟
端到端耗时至少包含:
浏览器启动与页面加载
  + 页面网络请求
  + DOM / Accessibility Tree 读取
  + 动作决策
  + 浏览器动作执行
  + 等待页面状态稳定
  + 结果解析
因此,“7 秒”可能受网络、缓存、航班网站响应、浏览器实例是否预热、动作数量和等待策略影响。复现实验时,必须同时记录模型时间和浏览器时间,而不能只看接口响应时间。
成本也不只等于输出 Token
一次浏览器任务的成本可能包括:
- 策略模型输入和输出;
- 文字输入回退模型;
- 页面内容预处理;
- 视觉模型调用;
- 浏览器基础设施;
- 代理、验证码和重试;
- 失败任务和人工接管。
原帖公开的 0.0039 美元是一次演示的账单结果。要把它变成可用的成本指标,至少需要补充任务成功率、P50/P95 延迟、平均动作数、回退比例和失败重试次数。
七、浏览器 Agent 的工程化架构
如果要把这类思路接入 GPT88 或自建 Agent 平台,可以将系统拆成六层:
任务层:用户目标、约束、完成标准
  ↓
状态层:DOM、Accessibility Tree、截图、网络和页面事件
  ↓
动作层:动态动作空间、动作 Schema、状态版本
  ↓
策略层:快速动作模型、文字模型、视觉模型
  ↓
执行层:浏览器驱动、等待、重试、取消和权限
  ↓
审计层:轨迹、成本、延迟、失败原因和人工接管
任务层:先定义完成标准
“查航班”不是完整任务定义。至少要明确:
- 出发地、目的地和日期;
- 单程还是往返;
- 是否允许转机;
- 需要返回哪些字段;
- 是否只读,还是允许提交;
- 结果为空时如何处理。
目标越明确,动态动作空间越容易收敛,结果也越容易评测。
状态层:保留原始事实
状态层应该保存可复核的页面事实,而不是只传给模型一个摘要:
- 页面 URL 和时间;
- DOM 或可访问性树快照;
- 截图引用;
- 网络与加载状态;
- 当前焦点和输入值;
- 页面状态版本。
这样发生误点击时,团队能判断是页面识别错、动作生成错,还是浏览器执行错。
执行层:所有副作用动作都要有门禁
读取航班结果可以自动完成;选择日期通常也可以自动完成;但购买、发邮件、提交表单、发布内容和删除数据,必须进入更高等级的风险策略。
只读查询       → 自动执行
可逆筛选       → 自动执行 + 状态校验
外部提交       → 明确确认
付款 / 删除     → 人工确认 + 幂等键 + 审计记录
速度优化不能绕开风险控制。一个每次都很快但偶尔自动下单的 Agent,不是高质量 Agent。
八、如何设计一套可复现的基准测试
不要只录一条“最顺利”的演示视频。建议至少准备四类任务:
| 测试集 | 目标 |
|---|---|
| 标准路径 | 页面稳定、字段清晰、无弹窗 |
| 页面变化 | 文案、排序、元素位置或 DOM 结构变化 |
| 输入困难 | 多语言、拼写错误、自动补全、日期格式 |
| 异常路径 | 超时、空结果、登录过期、弹窗遮挡 |
每条任务记录:
{
  "task_id": "flight-search-001",
  "success": true,
  "elapsed_ms": 7100,
  "action_count": 8,
  "text_fallback_count": 1,
  "visual_fallback_count": 0,
  "retry_count": 0,
  "estimated_cost_usd": 0.0039,
  "human_takeover": false
}
关键指标至少包括:
- 任务成功率;
- P50、P95 和最大耗时;
- 平均动作数;
- 文字和视觉回退比例;
- 无效动作率;
- 页面变化后的恢复率;
- 人工接管率;
- 单次任务成本;
- 高风险动作拦截率。
只有在这些指标都被记录后,才有资格比较“Jev + Browser Use”和其他浏览器 Agent 路线。
九、对 GPT88 接入的启发
这次演示最值得借鉴的不是某一个模型名字,而是路由思想:让不同模型处理最适合自己的输出形态。
在 GPT88 的统一 API 层,可以把浏览器 Agent 的模型路由做成显式配置:
browser_agent:
  state: dom_first
  action_model: jev-or-validated-fast-policy
  text_model: gpt-6-astra
  vision_model: validated-vision-model
  max_actions: 24
  allow_external_submit: false
  require_confirmation_for:
    - purchase
    - send
    - delete
需要特别注意:上面的模型名是路由示意,不代表 GPT88 控制台一定已经提供同名模型。真正接入前,应通过当前模型目录确认可用 ID、输入输出格式、计费单位和上下文限制。
一个可靠的 GPT88 浏览器 Agent 适配层,还应该记录:
- 实际使用的模型 ID;
- 每一步的状态摘要和动作 Schema;
- 是否发生模型回退;
- 每次调用的 request ID、耗时和费用;
- 浏览器页面版本和截图/DOM 快照引用;
- 用户是否确认过外部副作用。
否则,出现一次“视频里很快、线上却很慢”的问题时,团队无法判断是模型、页面、网络、回退还是重试导致的。
十、常见误区
误区一:7 秒代表所有网页任务都能 7 秒完成
错。它是一个具体演示。登录、验证码、复杂电商页面、动态表格、跨域 iframe、Canvas 应用和慢网络都可能显著增加耗时。
误区二:DOM 优先等于不需要截图
错。DOM 适合结构化交互,截图适合视觉状态。系统应该在两种状态表示之间按需切换。
误区三:策略模型越快,Agent 就越可靠
错。可靠性还取决于状态新鲜度、动作校验、执行回执、重试策略、权限和副作用门禁。
误区四:回退模型越多越好
错。没有明确触发条件的回退会掩盖主模型失败,也会让成本、延迟和输出归属变得不可解释。
误区五:演示视频就是基准测试
错。视频可以证明某次运行发生过,但不能单独证明平均性能、失败率、鲁棒性或生产可用性。
十一、落地检查清单
- 任务目标、成功标准和只读/写入边界已定义。
- DOM、可访问性树、截图和网络状态的使用顺序已定义。
- 动态动作空间只暴露当前任务真正需要的动作。
- 每个动作包含参数、目标元素、状态版本和风险等级。
- Jev/快速策略模型与文字模型的职责已分开。
- 回退触发条件、最大次数和成本上限已记录。
- 外部提交、付款、删除等动作默认需要确认。
- 轨迹保存了页面状态、动作、结果、模型 ID 和 request ID。
- 基准测试覆盖标准路径、页面变化、输入困难和异常路径。
- 指标包含成功率、P95 延迟、成本、回退率和人工接管率。
- 线上输出明确标注主模型还是回退模型完成了任务。
来源与边界
原始英文帖子:Gregor Zunic|Browser Use + Jev = Ultrafast。
中文解读帖:AYi_AInotes|Browser Agent 实测:7 秒完成航班搜索。
开源项目:browser-use/jev-ultrafast。
本文保留了两条来源的核心事实和原始演示媒体,并把中文帖中的工程解读与 GPT88 接入建议单独展开。7 秒、0.0039 美元、1 倍速、动态动作空间、DOM 状态和小模型文字回退属于来源披露或来源明确转述;架构图、验收清单和 GPT88 配置示例是本文的工程化整理,不代表原项目的完整内部实现,也不构成所有网页场景的性能保证。