
GEPA 提示词自进化:从人工调参到可解释的反思优化系统
提示词优化长期以来很像“人工炼丹”:改一句话、跑一批样本、看几个坏例,再继续加规则。它能够解决小规模问题,但一旦任务包含多种错误类型、业务偏好和输出约束,维护者很快就会面对三个难题:改动无法稳定复现、局部指标提升但泛化下降,以及提示词不断膨胀却没人说得清哪条规则真正有效。
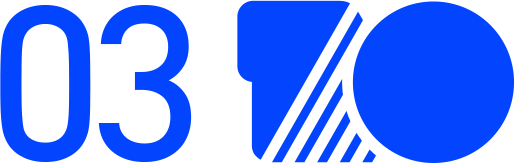
GEPA(Genetic-Pareto / Reflective Prompt Evolution)提供了另一条路径:把提示词视为可以被评估、反思、变异和选择的“程序”,让模型根据失败案例生成改进方向,再通过验证指标和 Pareto 前沿保留真正有价值的候选。
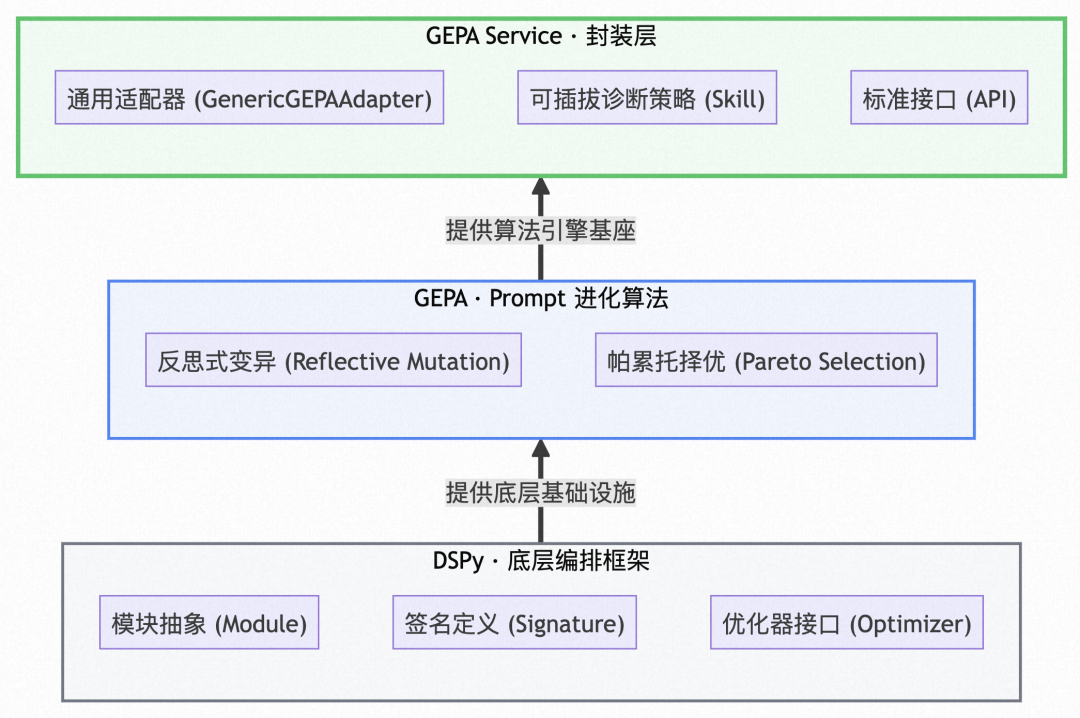
本文根据大淘宝技术文章《agent优化之GEPA——一种提示词自进化的优化方案》整理,并结合 Agent 工程实践补充生产化建议。文中的架构图和流程图均保留自原文,正文则按教程结构重新组织;原文提出的设计与设想不等同于 GPT88 平台已经内置的产品能力。
一、先看结论:GEPA 优化的不是一句话,而是一套闭环
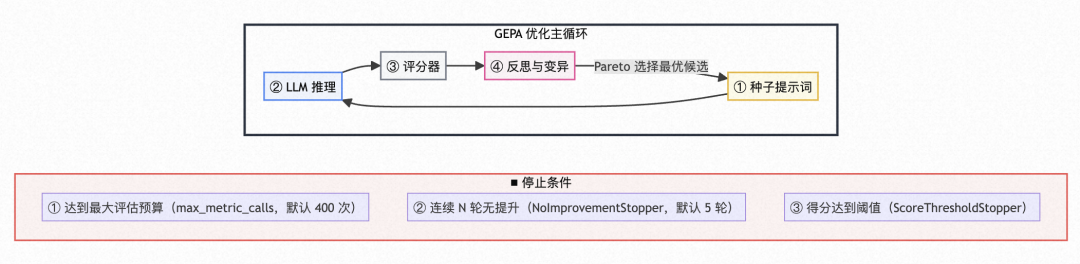
GEPA 的核心可以压缩为四个动作:
- 推理:让当前提示词在一批样本上执行任务。
- 评分:使用标签、规则、业务指标或 LLM Judge 判断输出质量。
- 反思:让反思模型阅读错误案例,解释错误来自提示词的哪一部分,并生成改写候选。
- 选择:比较候选在多个目标上的表现,保留 Pareto 前沿中的有效解,继续下一轮进化。
这与普通的“让模型帮我润色一下 Prompt”有本质区别。后者通常只看文本是否更完整,GEPA 则要求每次改写都接受数据集检验,而且要记录候选的来源、指标和演化关系。
二、为什么需要反思式提示词优化
1. 单一总分无法解释错误
假设一个商品匹配 Agent 的 F1 从 0.81 提升到 0.83,仅凭这个数字无法回答:
- 改进来自减少误判,还是减少漏判?
- 哪类商品改善最多,哪类反而退化?
- 模型是学会了更好的判断规则,还是绕开了输出约束?
- 新提示词在训练数据上更好,换到未见样本后是否仍然有效?
反思模型的任务,就是把“分数低”翻译为可修改的文本梯度。例如,它可以指出某类案例失败是因为提示词没有定义边界条件、判断顺序错误,或者异常输入缺少兜底策略。
2. 自由改写不等于有效搜索
让 LLM 无约束地重写 Prompt,常见结果是内容越来越长、约束越来越多,但指标并不稳定。GEPA 借用了遗传搜索的思想:从已有候选中选择父代,根据失败案例定向变异,再用验证结果决定是否进入下一代。
3. 多目标任务不应被压成一个权重
生产任务往往同时关心准确率、召回率、延迟、成本和提示词长度。把这些目标全部乘权重相加,会掩盖某些不可接受的退化。Pareto 选择更适合这类场景:只要一个候选在至少一个目标上更好、并且没有在其他目标上被全面压制,它就值得暂时保留。
三、系统中三个模型分别做什么
一个完整的 GEPA 系统通常包含三种角色,它们可以使用同一个模型,也可以按成本和能力拆分:
| 角色 | 主要职责 | 推荐特性 |
|---|---|---|
| 任务模型 | 执行实际分类、评分、比较或生成任务 | 输出稳定,温度低,价格适合批量评估 |
| Judge | 根据标签、规则或 Rubric 评价输出 | 标准一致,可解释,尽量避免与任务模型共享偏差 |
| 反思模型 | 阅读坏例和反馈,诊断提示词缺陷并生成候选 | 推理能力更强,允许适度探索 |
原文示例将任务模型设为低温确定性推理,将反思模型设置为较高温度以增加候选多样性。这种分工很合理,但生产环境还要加入两个约束:同一批候选必须使用一致的推理参数;Judge 的提示词和版本也必须固定并纳入审计。
四、一次优化循环如何运行
一次迭代可以按下面的顺序理解:
选择当前候选
  → 在训练样本上推理
  → 计算逐条分数与批量指标
  → 抽取失败样本
  → 生成规则反馈与 Judge 归因
  → 反思模型提出一个或多个变体
  → 在验证集评估变体
  → 更新 Pareto 前沿与候选树
这里有三个容易被忽略的细节:
- 反思输入必须包含证据:仅告诉模型“F1 较低”几乎没有用,应同时提供输入、期望答案、实际输出、规则评分和 Judge 归因。
- 候选不能直接看测试集:测试集只用于最终泛化评估,不能参与变异和选择,否则最终成绩会失去可信度。
- 每次变异要可追溯:至少记录父候选、修改摘要、使用的坏例、模型参数、各数据集指标和创建时间。
五、任务无关架构:不同任务只替换协议与评分器
GEPA 的价值不只在某一个二分类案例,而在于把共性流程抽象出来。一个任务无关的实现可以覆盖:
| 任务类型 | 典型输出 | 常用指标 |
|---|---|---|
| 二分类 / 多分类 | 标签或类别 | Accuracy、Precision、Recall、F1 |
| 数值评分 | 连续值或等级 | MAE、RMSE、相关系数、容差内命中率 |
| 两两比较 | A/B/平局 | 准确率、位置偏差、成对一致率 |
| 聚类 | 簇 ID 或归并关系 | ARI、NMI、Cohen's Kappa、Pairwise F1 |
| Rubric 评审 | 分项分数与理由 | Rubric 得分、一致性、人工相关性 |
适配新任务时,通常不需要重写整个优化引擎,只需实现四类协议:
- 如何把一条数据转成任务模型输入;
- 如何解析模型输出;
- 如何计算逐条分数和批量指标;
- 如何把失败结果转成反思反馈。
六、从数据到报告的五步工作流
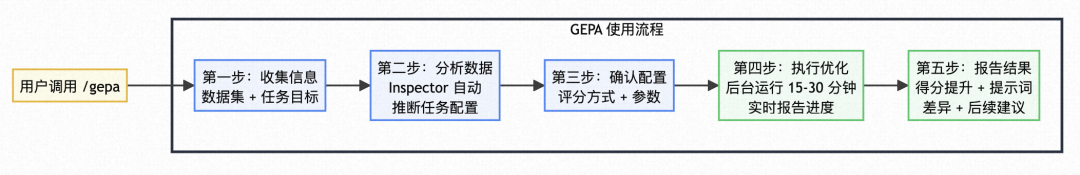
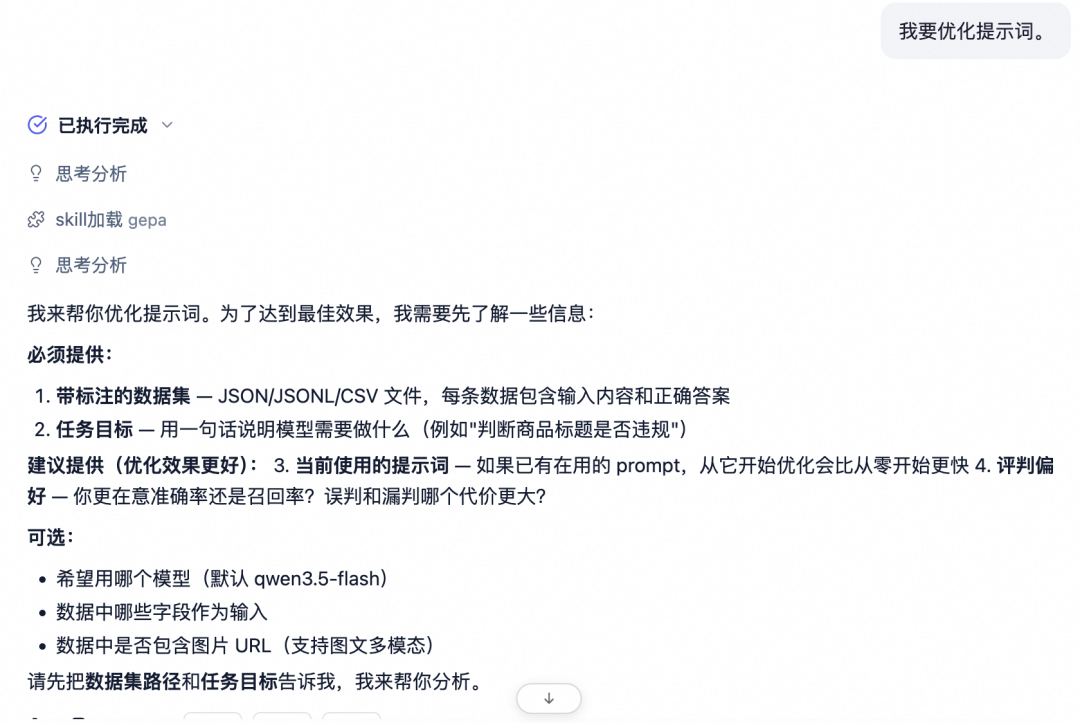
原文将使用流程分为五步,这也是比较适合做成 Skill 的交互路径:
- 收集任务信息:数据集路径、任务目标、现有 Prompt 和业务偏好。
- 自动分析数据:识别输入字段、答案字段、图片字段、标签分布和任务类型。
- 确认配置:展示系统推断结果,由用户确认模型、评分器、切分比例和预算。
- 执行优化:运行候选生成、评估、选择和状态持久化。
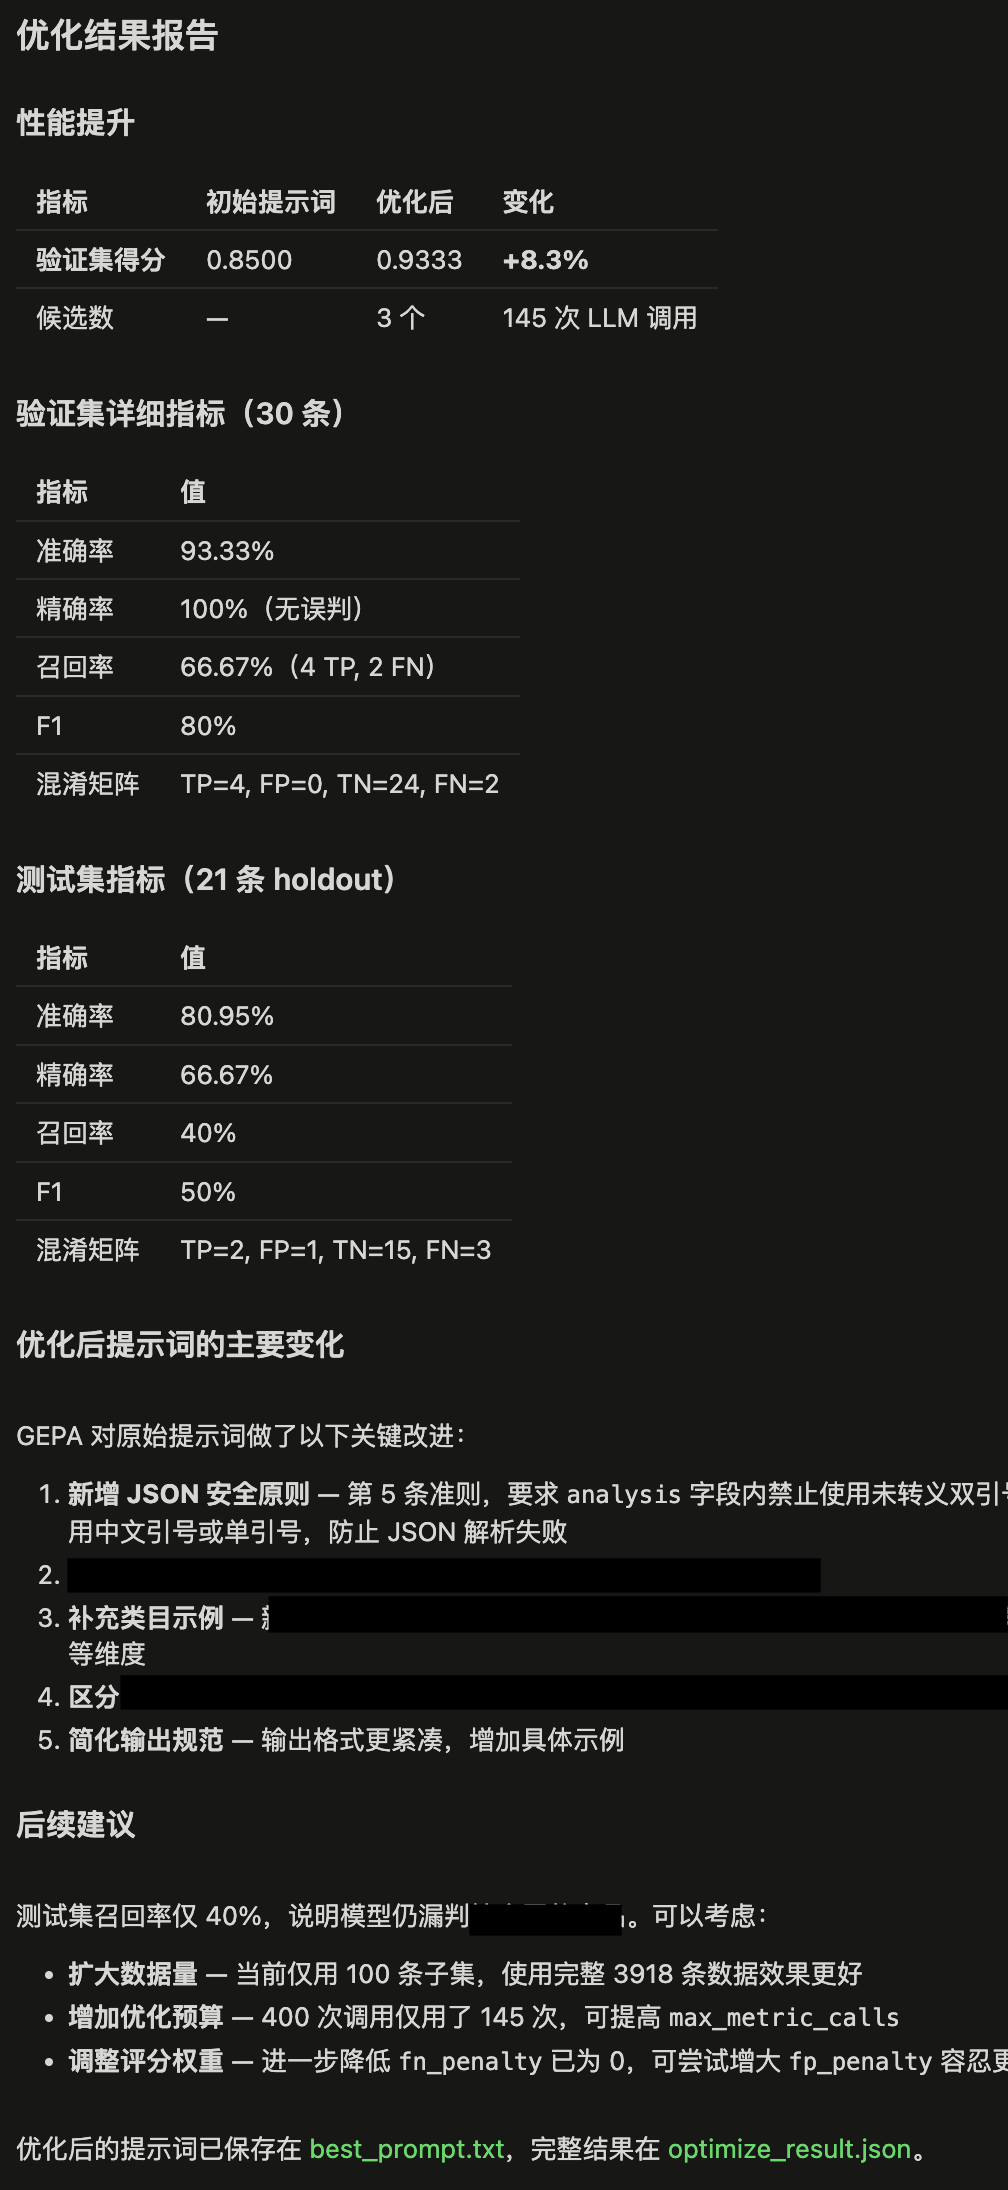
- 输出报告:给出最佳提示词、候选树、验证/测试指标、主要改动和后续建议。
最小输入要求
数据集至少需要两类字段:模型输入和正确答案。字段名最好与 Prompt 模板中的占位符一致。
{"title":"商品 A","description":"...","label":"same"}
{"title":"商品 B","description":"...","label":"different"}
初始提示词通常由两部分组成:
system_prompt:角色、判断规则、硬约束、输出格式
user_template:将数据字段注入任务的模板,例如 {title}、{description}
如果没有现成 Prompt,Inspector 可以根据字段、标签分布和样本内容生成种子版本。但自动生成只应被视为起点,涉及合规、工具权限和业务硬规则时仍需人工确认。
七、零配置并不等于无配置:Inspector 应该检查什么
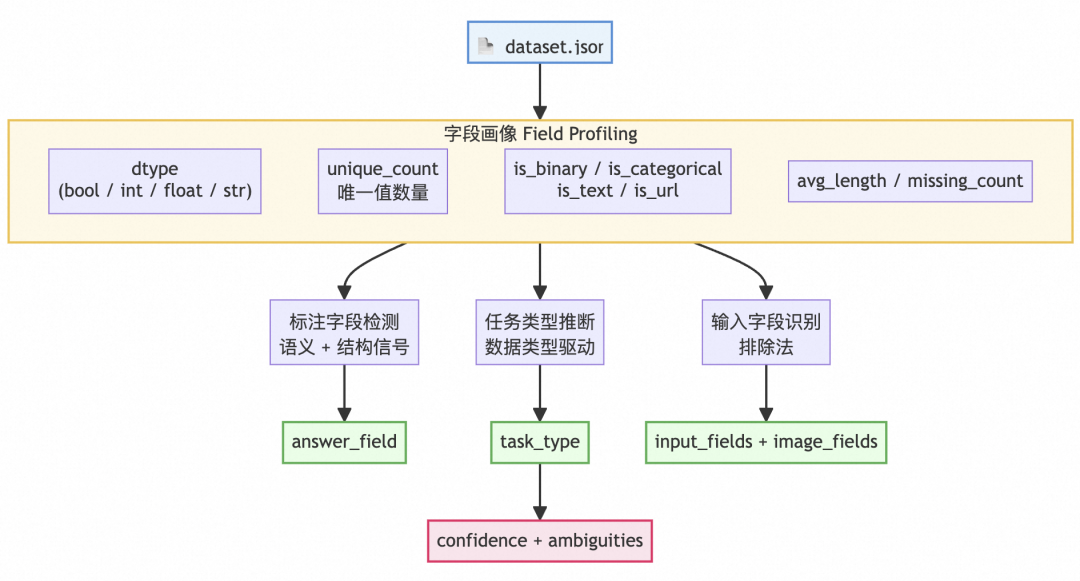
“零配置”更准确的含义,是系统先自动提出配置,再让用户确认,而不是隐藏所有决策。一个可靠的 Inspector 至少应完成:
- 读取 JSONL、JSON、CSV 等常见格式;
- 推断输入字段、答案字段和可能的图片 URL;
- 分析空值、重复值、类别分布和极端样本;
- 判断任务属于分类、评分、比较还是聚类;
- 选择默认解析器和评分器;
- 建议分层切分,避免小类只出现在单一数据集;
- 估算每轮调用量、Token 成本和最大预算。
原文示例采用训练集 50%、验证集 30%、留出测试集 20% 的默认分层切分。比例并非固定标准;数据量很小时,更重要的是保证各类别覆盖并使用交叉验证或重复抽样,避免一次随机切分决定最终结论。
八、分层工程架构怎么设计
为了让优化逻辑既能从命令行运行,也能接入 Skill 或服务端任务系统,可以按四层拆分:
| 层级 | 代表模块 | 职责 |
|---|---|---|
| 配置层 | config.py、config_factory.py | 数据、模型、评分、预算、切分和运行参数 |
| 优化引擎 | engine.py、adapter.py、run.py | 调度 GEPA 循环、候选评估、选择和状态恢复 |
| 任务组件 | data.py、inspector.py、parsers.py、scorers.py、feedback.py | 数据加载、任务推断、输出解析、评分与反馈生成 |
| 服务层 | api.py、jobs.py、progress.py | 参数校验、异步任务、进度事件和结果查询 |
对外接口应保持少而稳定,例如:
validate_config(config)
run_evaluate(config, prompt)
run_optimize(config)
这样上层 Skill 只需要负责交互和参数收集,不需要知道搜索算法的内部细节;API 服务也能复用同一个引擎,避免命令行、聊天入口和 Web 服务产生三套行为。
九、评分器决定了系统最终会“学成什么样”
优化器不会理解业务真实意图,它只会追逐你提供的奖励。因此,评分器设计比改写模型更重要。
分类任务
| 业务表述 | 建议目标 |
|---|---|
| 误判代价高 | 提高 Precision,对 FP 加大惩罚 |
| 漏判代价高 | 提高 Recall,对 FN 加大惩罚 |
| 两者平衡 | 使用 F1 或宏平均 F1 |
| 必须先达到精确率门槛 | 将 Precision 设为硬约束,再在可行候选中优化 Recall |
数值评分任务
线性误差适合一般偏差控制;平方误差会更重地惩罚大错。若业务存在明确容差,还应加入“容差内命中率”,避免平均误差掩盖边界失败。
比较与聚类任务
两两比较要专门检测位置偏差,例如交换 A/B 顺序后重复评估。聚类任务则需要同时关注是否过度合并和是否漏合并,不能只看簇数量或单一一致性指标。
LLM Judge
Judge 适合处理语义质量、理由完整性和复杂 Rubric,但必须定期与人工标签对齐。建议保留一批人工金标样本,测量 Judge 的准确率、一致性和位置偏差;如果 Judge 版本变化,应重新跑基线,而不是直接沿用旧分数。
十、反馈要分成规则层和语义归因层
只把错误答案交给反思模型,容易得到空泛建议。更有效的反馈可以分两层:
- 规则反馈:指出实际值、期望值、错误类型、违反了哪项格式或数值条件。
- Judge 归因:解释模型在哪一步理解错误,以及 Prompt 中哪段规则不清晰、冲突或缺失。
反思模型最终需要回答三个问题:
- 错误发生在哪里?
- 它与当前 Prompt 的哪一段有关?
- 最小且可验证的改动是什么?
“最小改动”非常重要。若每轮都重写整份 Prompt,候选之间的差异难以归因,也很难在退化时快速回滚。
十一、Skill 与 API 如何接入
Skill 入口适合做成向导,而不是直接暴露几十个配置项。它可以先询问任务目标和数据集,再由 Inspector 推断配置,最后只让用户确认有业务含义的选择。
一次运行建议输出以下可审计产物:
runs/<job-id>/
├── best_prompt.txt
├── optimize_result.json
├── candidates.json
├── candidate_tree.html
├── progress.jsonl
├── run_log.json
├── state.bin
└── best_outputs/
其中 best_prompt.txt 便于直接审阅和部署,candidates.json 与候选树用于解释演化过程,progress.jsonl 支持异步任务恢复和前端进度展示,逐条输出则用于回查指标异常。
服务化时,任务状态不应只保存在内存。至少应持久化配置、任务状态、进度事件、最佳 Prompt 和最终结果;长任务还要支持幂等启动、取消、超时、断点续跑和预算上限。
十二、生产落地最关键的六个风险
1. 冻结区被模型篡改
工具调用协议、输出 Schema、安全限制和合规规则不应该参与自由变异。建议把 Prompt 拆成:
| 区域 | 内容 | 是否允许进化 |
|---|---|---|
| 冻结区 | 权限边界、工具协议、Schema、禁止事项 | 否 |
| 可变区 | 判断顺序、业务偏好、异常处理、表达方式 | 是 |
与其在评分阶段惩罚违规候选,不如从结构上不把冻结区交给反思模型修改。
2. 提示词持续膨胀
反思模型很容易用“再补一条说明”解决每个坏例,最终造成 Token、延迟和维护成本同步上升。应把 Prompt 长度作为独立的 Pareto 目标,并设置字符或 Token 硬上限。
3. Reward Hacking
如果评分规则有漏洞,优化器可能删除限制、输出固定模板或利用解析器缺陷来获得高分。需要同时检查结构约束、语义质量和坏例分布,并对异常高分候选做人工抽查。
4. 测试集泄漏
测试集上的任何输出、错误摘要或指标都不能回流给反思模型。否则所谓“泛化提升”只是针对测试集继续调参。
5. Judge 偏差被放大
当任务模型、Judge 和反思模型来自相同模型家族时,它们可能共享偏好。可使用独立金标、异构 Judge、顺序交换、盲评和人工抽样降低风险。
6. 成本与延迟失控
一次候选变异可能触发训练集、验证集和 Judge 的多轮调用。运行前应估算:候选数量 × 样本数 × 平均 Token × 模型单价,并设置调用数、Token、金额和墙钟时间四类上限。
十三、没有 Ground Truth 时怎么办
部分 Agent 负责策略建议、营销创意或复杂决策,并不存在唯一正确答案。原文提出一种双通道设想:
- 离线评估通道:使用结构化 Rubric、历史规则、模拟器或对抗指标,对候选进行稳定的低成本筛选。
- 业务效果通道:使用线上转化、点击、人工复核或历史相似场景结果,对候选做排序和否决。
关键边界是:业务回溯结果可以帮助排序,但不应未经处理地回流反思。否则系统可能学会“少改动、贴近历史”就能得高分,最终把搜索推向保守解。
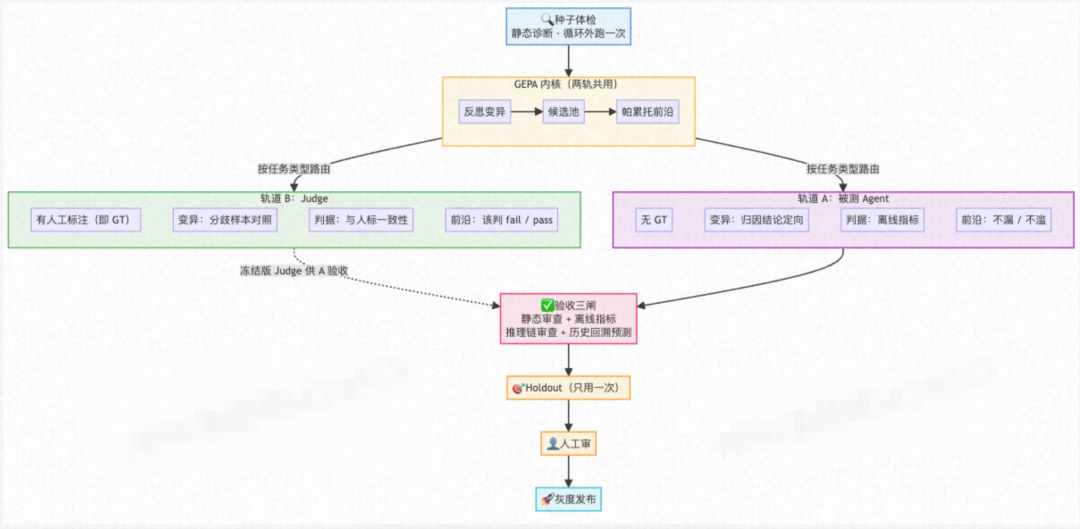
更稳妥的做法是把线上指标当作延迟反馈:先用离线门禁淘汰明显不合格候选,再进行小流量实验;只有通过统计检验、风险检查和人工审批的候选,才能进入更大流量。
十四、接入 GPT88 时的模型分工建议
如果通过 GPT88 统一调用不同模型,可以把三种角色分别配置,而不是用一个模型包办全部工作:
task_model:
  model: <从当前模型列表选择稳定、低成本的模型>
  temperature: 0

judge_model:
  model: <选择评判稳定或与任务模型不同家族的模型>
  temperature: 0

reflection_model:
  model: <选择推理与长上下文能力更强的模型>
  temperature: 0.7
模型 ID、价格、上下文、速率限制和协议兼容性可能随时间变化,应以 GPT88 控制台和当前 API Key 的模型列表为准,不要把博客中的示例名硬编码为长期配置。API Key 应放入环境变量或部署平台的密钥管理中,不能写入配置文件、日志或候选产物。
对于成本敏感任务,可以采用“便宜模型批量推理 + 稳定 Judge 评分 + 强模型只处理聚合后的代表性坏例”的结构,避免反思模型逐条阅读全部数据。
十五、上线前检查清单
- Prompt 已拆分冻结区和可变区。
- 训练、验证、测试数据严格隔离,且使用分层切分。
- 数据集包含困难样本、边界样本和真实类别分布。
- Judge 已与人工金标对齐,并检查顺序偏差。
- 每个候选可追溯到父候选、坏例、修改摘要和指标。
- Prompt 长度、调用次数、Token、金额和运行时间都有上限。
- 高分候选通过格式校验、安全门禁和人工抽查。
- 最终报告同时展示验证集和测试集,不只展示最佳单一分数。
- 部署采用灰度或 A/B 测试,并保留一键回滚到旧 Prompt 的能力。
十六、总结
GEPA 真正有价值的地方,不是“自动写出更漂亮的 Prompt”,而是把提示词优化变成一个可测量、可解释、可回滚的工程过程:用真实样本暴露错误,用规则和 Judge 生成反馈,用反思模型提出最小变异,再用多目标评估决定哪些候选值得保留。
但自动优化不会天然保证安全。评分器、数据切分、冻结区、预算和发布门禁决定了系统是在持续学习,还是在持续放大奖励漏洞。最可靠的实践,是让模型负责提出候选,让确定性的评估与治理层决定候选能否进入生产。
参考资料
- 原始文章:agent优化之GEPA——一种提示词自进化的优化方案,大淘宝技术,2026 年 9 月 16 日。
- GEPA 论文:GEPA: Reflective Prompt Evolution Can Outperform Reinforcement Learning,arXiv:2507.19457。
- DSPy 论文:DSPy: Compiling Declarative Language Model Calls into Self-Improving Pipelines,arXiv:2310.03714。
原文作者与团队
原文作者诗咏,来自淘天集团营销与交易技术团队。本文保留其公开文章中的署名、来源链接与原始配图,便于读者回到一手资料核对完整上下文。
सम्बन्धित गाइड
GPT-6 Astra 时代如何重写 Skills、AGENTS.md 与提示词