
cn-math-taxonomy:把中小学知识点、先修关系和前置诊断连成一张图
cn-math-taxonomy 是一个面向中小学学习路径的知识图谱项目。它把知识点、先修关系、课程标准、教材章节和选择题题库放进同一个数据模型,并提供在线知识图谱和自适应前置诊断工具。
项目最初以数学为核心,当前 README 已扩展到小学至高中数学、小学至高中英语、初中和高中物理,以及语文、科学、道德与法治和初中历史等学科。仓库提供 在线试用、知识图谱、诊断工具 和 GitHub Pages 备份。
重要边界:项目作者明确说明,这是 AI 生成的初稿,未经任何教师审核。知识点拆分、诊断答案、hard/soft 先修边,特别是高中、英语和部分教材目录,都不能直接当作官方课程标准、正式题库或教学决策依据。本文据项目公开 README、数据说明和许可证整理,项目统计为作者在仓库中公开的快照。
它试图解决什么问题
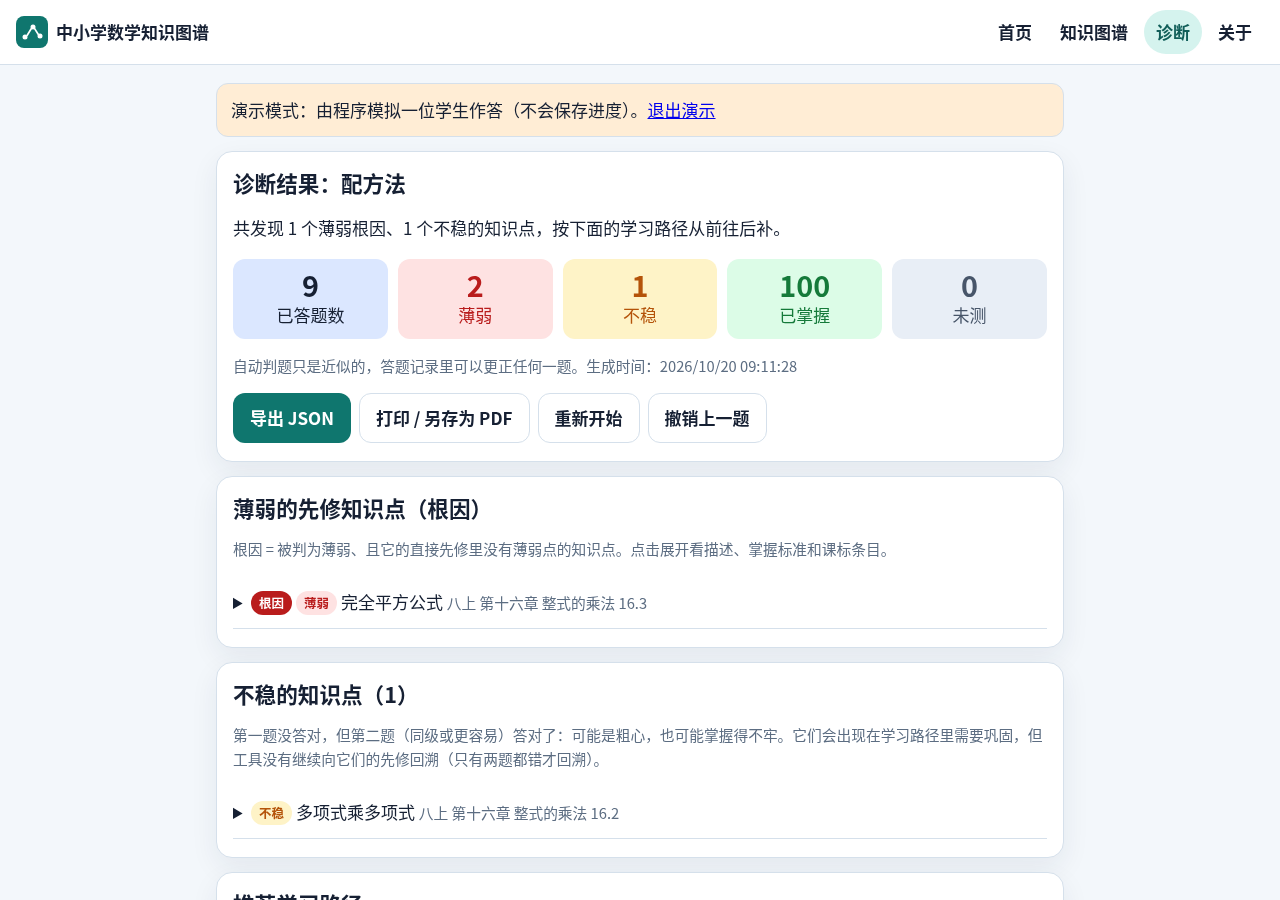
传统题库通常按章节或难度组织,学生答错后只能看到“这道题错了”。但一个错误可能来自更早的前置概念:做不出配方法,原因可能是完全平方公式;不会导数题,可能是函数、极限或代数变形还不稳定。
cn-math-taxonomy 的基本思路是把学习路径显式化:
知识点 + 先修边 + 课程标准 + 教材位置 + 诊断题
                         ↓
                   当前掌握状态
                         ↓
                   回溯前置薄弱点
当学生在一个目标知识点上答错,诊断器可以沿先修边回溯到更早的节点,再用针对性题目判断薄弱点在哪里。它不只是一个“按年级浏览目录”的网站,而是尝试把学习内容组织成可查询、可解释的依赖图。
数据模型:节点、边和题目
知识点节点
每个知识点通常包含唯一 ID、名称、学段/年级、教材章节、领域和可选的课程标准引用。不同学科使用不同的 ID 前缀,例如数学 cnm_、小学英语 cne_p、初中英语 cne_j、高中英语 cne_h,这样可以避免跨学科查询时混淆。
先修边
先修关系分为两类:
- hard:后续知识点真正依赖前置概念,没有它就很难完成目标任务;
- soft:推荐的学习顺序或常见关联,不代表严格的逻辑必要条件。
这个区别很重要。把教材顺序全部当作 hard 边,会让诊断图过度约束;把所有关系都当作 soft 边,又会失去回溯价值。项目 README 也提醒,先修关系本身仍需要一线教师审核。
诊断题
项目为知识点配套选择题,并在数据中记录难度、答案和验证字段。对小学和初中数学,README 还说明存在自动核验、盲解复核或独立程序复核;高中题和英语题没有做同等强度的盲解。因此,题目数量不等于题目质量,诊断结果也应保留题目版本和验证状态。
当前覆盖范围
README 的统计表显示,项目已包含多个学科和学习阶段。核心规模如下:
| 学科/阶段 | 知识点 | 先修边 | 题库 | 说明 |
|---|---|---|---|---|
| 小学数学 1–6 年级 | 284 | 459 | 1,136 | 对齐第一至三学段,含跨年级回溯 |
| 初中数学 7–9 年级 | 315 | 563 | 1,407 | 含新版教材目录调整 |
| 高中数学必修 | 143 | 144 | 572 | 人教 A 版(2019) |
| 高中数学选择性必修 | 128 | 148 | 512 | 课程标准和目录部分待核 |
| 小学、初中、高中英语 | 791 | 1,028 | 3,164 | 语音、词汇、语法、表达、读写 |
| 初中、高中物理 | 269 | 637 | 1,076 | 数学依赖单独记录在 mathLinks |
此外,仓库 README 还列出语文、科学、道德与法治和初中历史的数据。各学科的具体统计会随生成脚本和内容更新变化,使用时应以仓库当前数据和对应 README 章节为准,不要把文章中的表格当作永久 API 契约。
数学图谱是项目的主要示例:它可以从高中、初中一路回溯到小学知识点。英语单独成图,初中英语可以连回小学英语,高中英语主要连回初中英语;物理也单独成图,使用到的数学概念放在 mathLinks 中,不直接混入物理先修边。
四个适合实际使用的入口
1. 首页:先看范围和学段
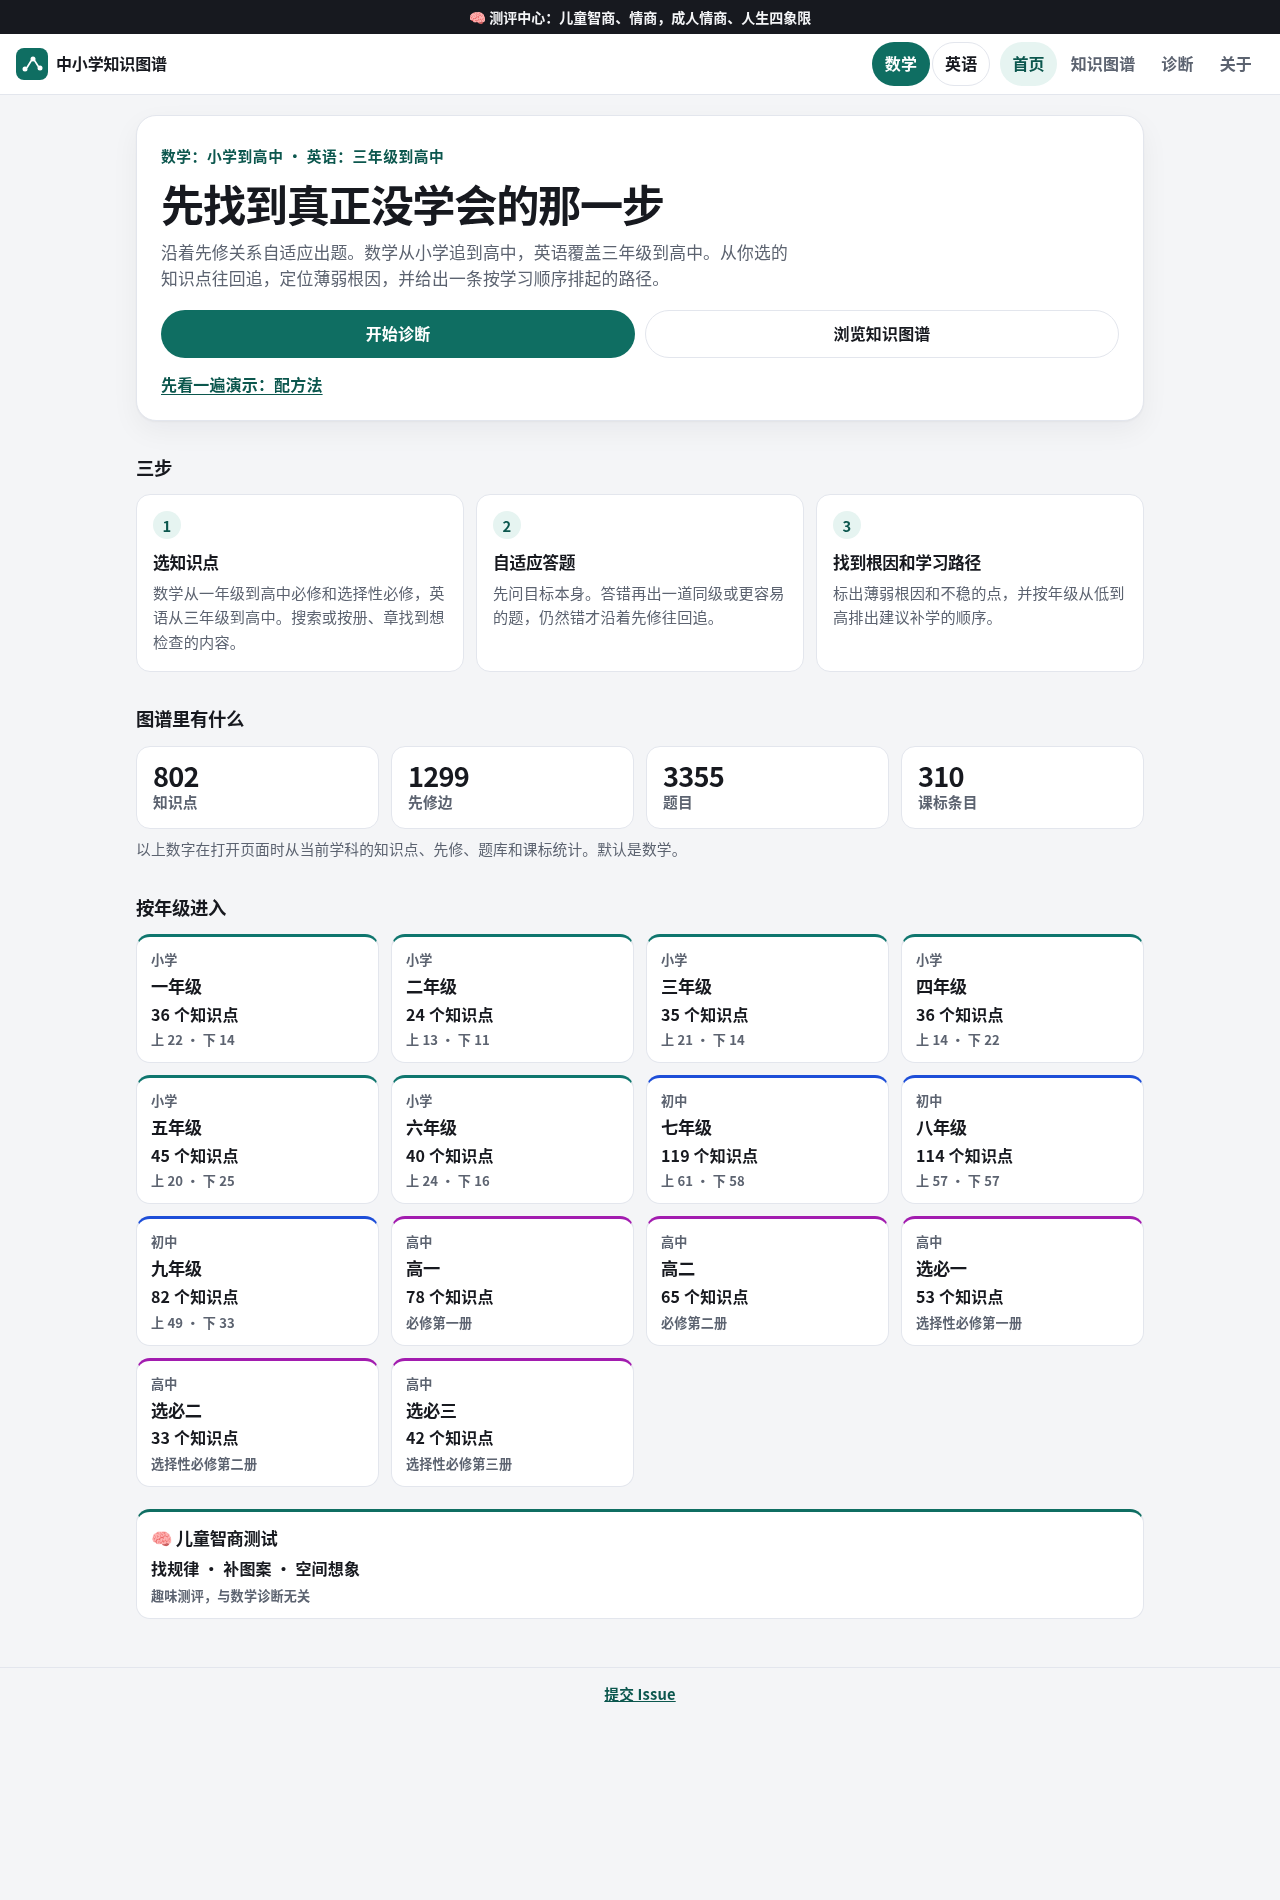
首页提供年级入口、学科切换和实时统计。默认数学入口保持不变,英语、科学、历史等学科通过 ?subject= 切换。例如:
https://math.pansgo.com/?subject=english
https://math.pansgo.com/?subject=history
进入具体学科前,先看节点数量、题库数量和哪些内容仍标记为“待核”,可以避免把演示范围误认为完整课程。
2. 知识图谱:查看一条概念链
Explore 页面 适合从一个知识点向上看先修、向下看后续。一个好的阅读方式是先选择一个目标点,再分别检查:
- 直接前置点是什么;
- hard 和 soft 边是否混合;
- 目标点属于哪个教材章节;
- 它有没有课程标准来源;
- 是否有足够的题目支持诊断。
图上的连线是项目建模结果,不是教育部或出版社发布的官方“唯一学习顺序”。如果发现不合理关系,仓库提供了 题目纠错和功能建议 Issue 模板。
3. 诊断页面:从错题回到前置概念
Diagnose 页面 可以针对一个目标点或整册进行前置筛查。数学示例可以从配方法开始,也可以直接诊断高中函数、导数或选择性必修章节。
诊断结果最适合作为下一步复习建议,而不是给学生贴“掌握/不掌握”的固定标签。一次答错可能来自计算失误、题意误读、题目本身的问题或知识点确实薄弱。实际使用时应结合多道题、作答过程和教师观察。
4. 数据文件:作为内容管线输入
仓库将节点、依赖、课程标准和题库拆成 JSON 等数据文件,并保留生成脚本。研究者或开发者可以使用这些文件生成自己的搜索、可视化、练习或课程页面,但应锁定 commit,记录数据版本,避免直接依赖 main 分支的实时内容。
自适应前置诊断可以怎样工作
一个可解释的诊断循环可以是:
- 用户选择目标知识点或教材章节。
- 系统取出目标点的直接 hard 前置和必要的 soft 前置。
- 从基础、标准、挑战三个层次挑选题目。
- 根据作答结果更新节点状态,而不是只更新一个总分。
- 若前置点连续失败,沿图向上继续检查;若基础题通过,则减少重复测试。
- 输出“建议复习哪些点、依据哪些题目、是否需要人工确认”。
这样的设计比“随机出题直到分数达到阈值”更容易解释,因为推荐路径可以回到具体的节点、边和题目。要让它适合教学,还需要校准题目难度、设置停止条件、记录置信度,并允许教师覆盖自动判断。
课程标准与教材对齐:要看来源状态
项目将课程标准和教材章节作为节点元数据的一部分,但 README 对来源状态做了细分:部分小学、初中教材目录已通过国家中小学智慧教育平台核对;部分目录来自第三方电子课本站;高中条目、英语课标、部分新版教材目录标为待核或公开转述。
使用时建议把来源状态显示出来:
| 状态 | 适合的表达 |
|---|---|
| 官方目录或原文已核 | “按某版本目录整理,已核对” |
| 公开转述、页码待核 | “依据公开转述,待逐页核验” |
| 第三方目录推定 | “作为暂定章节映射,不代表官方原文” |
| AI 生成初稿 | “需要教师审核后使用” |
尤其不要把仓库自编的课程标准编号当作教育部原编号,也不要把“对齐课标”写成“获得教育主管部门认证”。
教师和开发者如何一起复核
教师侧:先看语义和边界
- 知识点是否拆得足够小,能对应一项可观察能力?
- hard 边是否真的是必要前置,而不是常见教学顺序?
- 题干、选项和答案是否符合当前教材和学段?
- 同一个知识点是否被不同年级或学科重复定义?
- 对开放性内容,是否错误地使用了唯一答案?
工程侧:再看数据和行为
- JSON schema 是否稳定,空字段和枚举是否明确?
- 图谱是否存在环、孤立点或无法到达的节点?
- 题目答案与
verify逻辑是否一致? - 诊断结果是否能回到题目、节点和边的来源?
- 更新教材版本时,旧数据和已有学习记录如何迁移?
产品侧:最后看反馈
- 学生能否理解为什么被推荐复习某个点?
- 教师能否修改或驳回自动诊断?
- 家长看到的结果是否避免了过度精确的能力分数?
- 错题和学习记录是否提供删除、导出和隐私控制?
许可和复用边界
仓库根目录的许可证为 CC BY-NC 4.0,即允许在署名和非商业条件下分享、改编和再利用。把数据复制到付费课程、商业题库、广告产品或其他商业服务前,应先确认是否获得额外授权;第三方教材、课标和题目素材也可能有独立版权和使用条件。
即使属于非商业使用,也应保留项目名称、仓库链接、作者信息和修改说明,并单独核对 assets/vendor/ 下第三方库的许可证。不要因为代码仓库公开,就默认其中的教材内容、题目、截图和课程标准文本都可以自由再分发。
一个稳妥的试用顺序
- 先打开在线演示,选择一个熟悉的数学知识点,观察图谱中的 hard/soft 关系。
- 用少量题目检查诊断结果是否能解释自己的错误,而不是先导入全部学科。
- 在本地固定一个 commit,读取对应 JSON,检查字段和来源状态。
- 让教师或学科专家审核目标年级的节点、题目和先修边。
- 只有在数据质量、隐私、版本和许可证都明确后,才把图谱接入自己的学习产品。