
Story Studio 故事工坊:把历史人物短视频拆成可审核的 AI 制作流水线
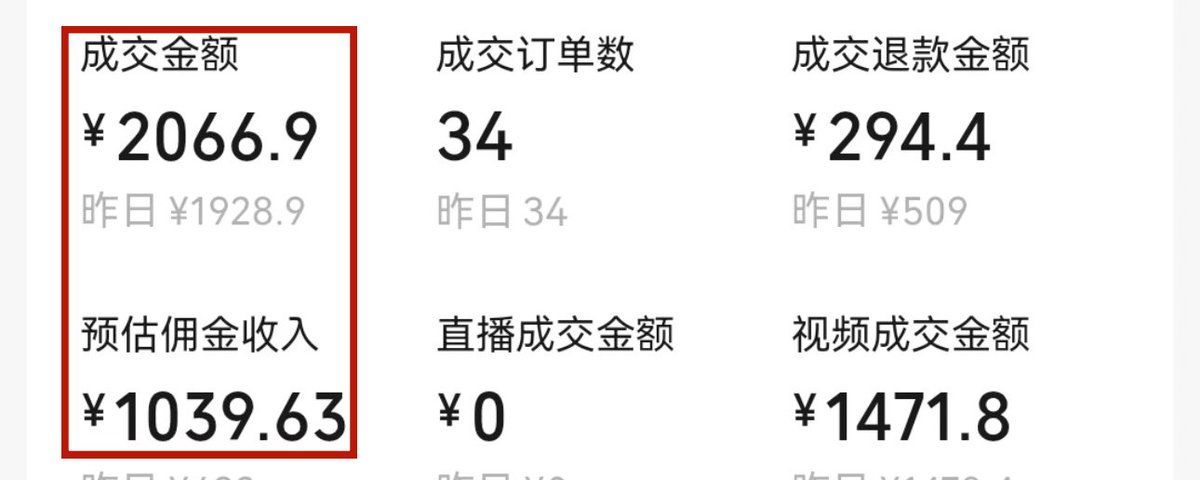
本文根据 夏木 GROW 的 X 长文整理,并核对了 konlu/story-studio 的 README、SKILL.md 和 MIT 许可证。原帖发布于 2026 年 10 月 27 日。作者披露的播放量、涨粉、成交和佣金数字属于个人自述,本文未独立核验,不代表工具效果或收益保证。
它想解决什么问题
制作一条历史或人物故事短视频,通常要经过选题、资料核实、写口播稿、配音、字幕时间轴、分镜、配图和剪辑。每个环节都可能需要不同工具,反复搬运文件也容易造成稿件、音频和画面版本对不上。
Story Studio(故事工坊) 是一个为 Codex、Claude Code、Cursor 等编码 Agent 准备的开源 Skill。它把这条工作链整理到同一个项目入口中,按用户的请求选择开启哪些阶段:可以只写稿,也可以拿现成音频和图片继续做时间轴与剪映草稿。
选题与资料核实
  → 口播稿与开头备选
  → 豆包 TTS 或自备配音
  → Coli 本地转录与音文核对
  → 按时间戳拆分镜、准备图片
  → 生成可编辑剪映专业版草稿
  → 人工复核与导出
它的主要价值是把阶段交接和项目文件结构标准化,而不是保证每次生成都能成为爆款。文章接下来按这条流水线拆解它的实际功能。
五个环节分别做什么
1. 选题与口播稿
README 介绍了两类主要写作模块:历史叙事和真实人物故事。历史叙事侧重提出问题、解释人物行动与制度因果,再兑现开头的悬念;人物故事模块则提供人物传记式的叙述结构和开头钩子模板。
使用时可以先只让 Agent 做选题、列事实时间线并给出多个开头版本,确认方向后再写完整稿。稿件生成后应检查每个时间、数字、引语、人物关系和因果判断的来源。仓库 README 也明确说明,对标语料用于学习叙事结构,不是历史事实依据。
对于历史内容,建议把“事实核查”设成一个独立交付物:列出主张、出处、可信程度和需要人工确认的争议。不能因为 Skill 有模板或文案库,就把模型生成的细节当成已证实史实。
2. 配音与音频时间轴
项目支持两种配音路线:调用火山引擎豆包语音合成,或使用创作者准备好的 MP3。随后可用 Coli(基于 sherpa-onnx)在本地转录音频,生成带时间信息的字幕,再与定稿文本核对。
“先有最终配音,再依音频拆镜”是流程中的关键安排。若先按文字长度平均切分镜头,语速停顿、重读、句间空白和实际语音时长都会导致画面与台词错位。真实音频时间戳能给分镜提供更可靠的起止边界,但专有名词、人名和年代仍需人工核对。
语音合成会产生服务费用,具体资源、音色、价格和可用性要以服务商当前文档为准。首次配置或调用前应确认费用、音色和文本范围;密钥只能放在安全配置中,不应写进项目文件、聊天记录或 Git 仓库。
3. 分镜与配图
仓库 README 描述了三种视觉风格:厚涂历史漫画、黑白纪实叙事和历史写实。工作流会根据口播时间轴安排镜头,并尝试通过参考图片、人物年龄阶段和时代服饰信息减少镜头间画风漂移。
项目也支持只产出带时间的分镜表和独立提示词,再交给创作者指定的图像工具处理。这个模式适合希望自己控制模型、素材或费用的人。实际调用生图 API 可能产生费用,不能因为 Skill 已经安装就默认授权批量生成。
历史题材的图像需要格外谨慎:模型可能生成错误的服饰、器物、建筑或人物形象。风格参考图只能帮助保持视觉一致性,不能证明它描绘了真实历史。需要展示真实人物或历史现场时,应说明是 AI 示意图,并核查图片是否会让观众误以为它是档案照片。
4. 剪映草稿
Story Studio 使用 pyJianYingDraft 写入剪映专业版草稿,按 README 的说明可以铺设图片和配音,并为静态图片添加慢推拉或切点缩放。项目还强调导出前的时间轴和画面语义核对,素材会复制到草稿目录,减少路径丢失。
导出草稿不等于视频已经完成。创作者仍需打开剪映检查音画同步、图片顺序、转场、字幕、裁切和素材可用性,再决定是否修改并导出 MP4。原帖提到的 4K 或 1080P 是草稿后续导出的选择,不代表每台设备都能顺畅完成相同设置。
5. 阶段开关与已有项目接续
项目把写作、配图和剪映草稿作为不同阶段处理。已经有文稿、音频或图片时,可以只让 Agent 完成下游步骤,避免不必要的重写和重复生图。
开始前把请求写具体,例如:
只处理现有定稿和配音:使用 Coli 对齐音频与文稿,输出带时间戳的分镜表。
不要生成图片,不要生成剪映草稿。
或者:
使用已确认的脚本、音频和图片,生成剪映草稿并保留旧版本。
不重写文案、不重新配音、不调用生图工具。
这种阶段边界可以减少不需要的模型调用,也让用户知道当前会产生什么文件、费用和外部请求。
开始使用前的检查
仓库和安装脚本
项目的代码与 Skill 规范采用 MIT 许可证。README 提供通过 Agent、终端克隆或压缩包安装的路径。即使项目开源,也建议先检查仓库版本、安装脚本将要写入的位置、依赖来源和系统权限,再运行自动初始化。首次只写文案时,不必预先安装配音、转录和视频导出所需的全部媒体依赖。
安装或更新后,先让 Agent 检查当前 Skill 规则与工作目录,使用一个不含私人资料的小样例跑通单个阶段;确认输出后再尝试整条流水线。Skill 能指导 Agent 调用工具,但不能替代用户对文件、权限和外部服务请求的确认。
API、图片和运行成本
全流程可能涉及模型生成、豆包 TTS、图片生成、语音转录、浏览器逐帧渲染和本地视频处理。不同阶段的费用和资源消耗不同。正式批量制作前,建议先用一条短片记录:
- 每个阶段使用了什么模型、API 或本地工具;
- 文案、TTS 和生图的调用次数与费用;
- 转录、图片生成和渲染各自花费的时间;
- 人工修改、核史和剪映复核花费的时间;
- 最终素材是否符合平台发布和商业用途要求。
原帖称作者在首次合成或批量生图前会确认调用;实际使用仍应检查当前代码和客户端行为,不能只根据 README 的描述假定费用控制已经满足自己的要求。
历史内容、声音与商业推广
短视频叙事模板可以帮助组织内容,但不能把情绪钩子放在准确性之前。尤其是人物生平、医疗或健康主题,应尽量引用可靠资料,不要杜撰引语、数字或治疗效果。
如果配音使用声音克隆或参考音色,必须取得声音权利人明确授权;不要下载他人的公开视频音频来仿制声音。使用真实人物照片、音乐、字体、图书封面和网络图片,也要分别确认授权范围。MIT 许可证只覆盖项目自身许可范围,不会自动覆盖第三方语料、素材和生成结果。
原帖中提到图书、滋补健康产品、评论区引导和私域转化。这些属于作者的商业化建议,不是 Skill 的技术能力。推广时应遵守平台规则,对广告、佣金和关联关系作清晰披露;涉及健康产品时,不要暗示未经证实的疗效,也不能用人物故事替代产品证据。
怎样看待原帖里的流量和收入数字
原作者称这套流程帮助其制作历史和人物故事短视频,并分享播放、完播、涨粉、带货和佣金数据。这些数字来自作者自述;目前无法从公开仓库 README 独立验证账号后台、统计周期、投流情况、退款、退货、成本或样本选择。
即使某个账号取得了特定结果,也不能推导出安装同一个 Skill 就能复制收益。结果还会受选题、素材质量、账号历史、发布时间、平台推荐、受众、投放、商品和转化路径影响。把这套项目当作内容制作工具来评估,比把它当作变现承诺更稳妥。
一个低风险的试用顺序
- 查看 Story Studio 仓库 的 README、许可证和最近变更。
- 先在独立目录只运行“选题或口播稿”阶段,不配置付费服务。
- 用可靠来源人工核验人物资料,修改不准确或缺乏证据的内容。
- 选一段有权使用的配音,或在确认成本后试用合法授权的 TTS 音色。
- 先做少量分镜和图片,检查年代、人物、画风和语义是否匹配。
- 生成剪映草稿后逐镜复核,再发布或用于商业推广。
如果工作目标只是把文章改成口播稿,可以停在写作阶段;如果需要可编辑视频,再逐步打开配音、分镜和剪映草稿。按需启用阶段,能够更清楚地控制成本、素材和权限。
来源
- 夏木 GROW:Story Studio 故事工坊原帖与长文
- konlu/story-studio GitHub 仓库
- Story Studio README
- Story Studio SKILL.md
- Story Studio MIT License
本文只整理项目当前公开描述和原帖观点。仓库功能、依赖、语音服务参数和安装方法可能变化;执行前请查看仓库最新文档。作者公开的商业数据未经独立核验,不构成收益预测或保证。